rustfs otlp
rustfs 接入OpenTelemetry示例 官方文档:https://docs.rustfs.com/zh/operations/observability
rustfs 配置
/etc/default/rustfs
# 改为info查看更多日志调试
RUST_LOG=info
# 增加
RUSTFS_OBS_ENDPOINT="http://test-rustfs-5.hiido.host.int.yy.com:4318"
RUSTFS_OBS_LOGGER_LEVEL="rustfs=debug,info"
# 重启服务
systemctl restart rustfs
OpenTelemetry Collector 配置
这里可以自己编译源码,https://github.com/open-telemetry/opentelemetry-collector
如果只测试,就下载社区提供的二进制包contrib。
指标查看:http://10.12.70.85:8889/metrics
sudo apt-get update
sudo apt-get -y install wget
wget https://github.com/open-telemetry/opentelemetry-collector-releases/releases/download/v0.161.0/otelcol-contrib_0.161.0_linux_amd64.deb
sudo dpkg -i otelcol-contrib_0.161.0_linux_amd64.deb

# 二进制文件
/usr/bin/otelcol-contrib
# 配置文件在
/etc/otelcol-contrib/config.yaml
#需要修改默认配置,加上prometheus
exporters:
  debug:
    verbosity: detailed
  prometheus:                     # 新增:暴露给外部 Prometheus 抓取
    endpoint: 0.0.0.0:8889        # 用 8889,避开被占用的 8888
  otlp/tempo:                    # ← 新增
    endpoint: localhost:14317    # Tempo 同机,OTLP/gRPC 端口
    tls:
      insecure: true             # 内网无 TLS,必须加,否则报证书错误
  otlphttp/loki:                 # loki
    endpoint: "http://127.0.0.1:3100/otlp"
    tls:
      insecure: true

service:
  pipelines:
    metrics:
      receivers: [otlp, prometheus]
      processors: [batch]
      exporters: [debug, prometheus]   # 加上 prometheus
    traces:
      receivers: [otlp, jaeger, zipkin]
      processors: [batch]
      exporters: [debug, otlp/tempo]   # ← 加上 otlp/tempo
    logs:
      receivers: [otlp]
      processors: [batch]
      exporters: [debug, otlphttp/loki]

# 启动服务
systemctl start otelcol-contrib
systemctl status otelcol-contrib
prometheus 配置
# 配置 新增加
scrape_configs:
  - job_name: 'rustfs-via-otel'
    scrape_interval: 15s
    static_configs:
      - targets: ['10.12.70.85:8889']   # RustFS 的业务指标
  - job_name: 'otel-collector-self'
    scrape_interval: 15s
    static_configs:
      - targets: ['10.12.70.85:8888']   # collector 自身运行指标(可选)

# 启动
nohup  /usr/local/prometheus/prometheus \
  --config.file=/usr/local/prometheus/prometheus.yml \
  --web.enable-admin-api \
  --web.listen-address=:9090 \
  --storage.tsdb.path=/data/prome_data/rustfs \
  --storage.tsdb.retention.time=30d 2>&1 &
grafana 相关配置
grafana
安装grafana 用于展示指标数据。 http://10.12.70.85:3000
wget https://github.com/grafana/grafana/releases/download/v13.2.2/grafana_13.2.2_34846740809_linux_amd64.deb
dpkg -i grafana_13.2.2_34846740809_linux_amd64.deb
...
### NOT starting on installation, please execute the following statements to configure grafana to start automatically using
 sudo /bin/systemctl daemon-reload
 sudo /bin/systemctl enable grafana-server
### You can start grafana-server by executing
 sudo /bin/systemctl start grafana-server

# 默认端口3000 访问
cat /etc/grafana/grafana.ini | grep http_port
tempo
安装grafana tempo 用于存储traces数据。 http://10.12.70.85:3200/metrics
wget https://github.com/grafana/tempo/releases/download/v3.1.0-rc.1/tempo_3.1.0-rc.1_linux_amd64.deb
dpkg -i tempo_3.1.0-rc.1_linux_amd64.deb
# system 服务配置文件
ll /etc/systemd/system/tempo.service
# tempo 配置文件
ll /etc/tempo/config.yml
# 需要解决冲突端口
distributor:
  receivers:
    otlp:
      protocols:
        grpc:
          endpoint: "0.0.0.0:14317"
        http:
          endpoint: "0.0.0.0:14318"
# 把默认/var/目录改为/data/
cat /etc/tempo/config.yml | grep data
    path: /data/tempo/generator/wal
      path: /data/tempo/wal             # where to store the wal locally
      path: /data/tempo/blocks

mv /var/tempo /data/tempo
# 启动
systemctl start tempo

# 验证日志
journalctl -u otelcol-contrib -f -o cat \
  | grep --line-buffered -iE 'service.name|Span|Str\(rustfs'
traces 使用说明:
有了 trace 能看到什么?
在 Tempo/Grafana 里,按 duration > 2s 一筛,点开那条 3 秒的 trace,直接展开成一棵span 调用树:
PutObject                                   3.02s   ← 根 span
├─ auth_check                                 2ms
├─ erasure_encode                            15ms
├─ write_shards (并行)                       2.94s   ← 时间都花这了
│   ├─ write data1  @test-rustfs-1           38ms   ✓
│   ├─ write data2  @test-rustfs-1           41ms   ✓
│   ├─ ...(其余 9 块都是 40ms 左右)          ~40ms  ✓
│   └─ write data7  @test-rustfs-3          2.90s   ← 元凶!
└─ quorum_wait                               (被 data7 拖住)
一眼定位:12 块里有 11 块都是 40ms,唯独 data7(在 test-rustfs-3 上)花了 2.9 秒——很可能是 test-rustfs-3 上那块磁盘 IO 异常/快坏了。
这个结论,单靠 metrics(只有聚合数字)和 log(慢请求不报错)永远推不出来。trace 的价值就在于:把一个请求跨越多个节点、多个步骤的完整因果链拼成一条时间线,让你直接看到时间/错误消耗在哪个 span。 trace 真正的用武之地(总结成几类)
| 场景 | 为什么 metrics/log 不够,trace 才行 |
|---|---|
| 慢请求定位 | 慢但成功的请求不报错;metrics 只有聚合值。trace 能下钻到具体是哪个 span 慢 |
| 跨节点/跨服务的调用链 | RustFS 一次请求扇出到多节点多磁盘,log 分散无法关联。trace 用同一个 trace_id 串起全链路 |
| 偶发/长尾问题(P99) | 平均值正常、偶尔抖动,靠翻日志碰运气。trace 可按 duration 精准捞出那几条异常请求 |
| 错误根因传播 | 客户端看到 500,但根因在下游第 3 个节点。trace 能看到错误从哪个 span 最先产生、如何向上冒泡 |
| 依赖瓶颈分析 | 想知道请求时间到底花在编码、网络、还是磁盘。trace 的每个 span 都有独立耗时 |
log
查看otel中的rustfs日志:
journalctl -u otelcol-contrib -f -o cat | grep -E 'SeverityText:|Body:'
SeverityText: INFO
Body: Str(HTTP request completed)
SeverityText: INFO
Body: Str(HTTP request completed)
...
下载安装grafana-loki 用于查看日志:
http://10.12.70.85:3100
# 下载核心服务端和 LogCLI 工具
wget https://github.com/grafana/loki/releases/download/v3.7.8/loki_3.7.8_amd64.deb
wget https://github.com/grafana/loki/releases/download/v3.7.8/logcli_3.7.8_amd64.deb

# 安装软件包
sudo dpkg -i loki_3.7.8_amd64.deb logcli_3.7.8_amd64.deb
Adding system user loki (UID 115) ...
...

# 修改配置文件
mkdir -p /data2/loki/chunks /data2/loki/rules
chown loki:nogroup /data2/loki -R

vim /etc/loki/config.yml

common:
  instance_addr: 127.0.0.1
  path_prefix: /data2/loki
  storage:
    filesystem:
      chunks_directory: /data2/loki/chunks
      rules_directory: /data2/loki/rules

# 启动服务
systemctl daemon-reload
sudo systemctl enable --now loki
systemctl start loki
systemctl status loki

# 查看日志
journalctl -u loki -f -o cat | grep --line-buffered -iE 'level=info|level=error'
```bash
logcli 查询日志
# 设置环境变量,避免每次都输入 --addr
export LOKI_ADDR="http://localhost:3100"

# 查看所有已索引的 Label 列表
logcli label
# 常用查询
logcli query '{service_name=~".+"}' --limit=10
logcli query '{service_name="rustfs"}' --limit=20
logcli query '{service_name=~".+"}' --tail

# 安装jq工具
apt-get update && apt-get install -y jq

curl -s -G "http://localhost:3100/loki/api/v1/query_range" \
  --data-urlencode 'query={service_name=~".+"}' \
  --data-urlencode 'limit=5' | jq '.data.result[] | {stream: .stream, values: .values}'

curl -s -G "http://localhost:3100/loki/api/v1/query_range" \
  --data-urlencode 'query={service_name=~".+"} |= "ERROR"' \
  --data-urlencode 'limit=10' | jq .
在grafana中展示
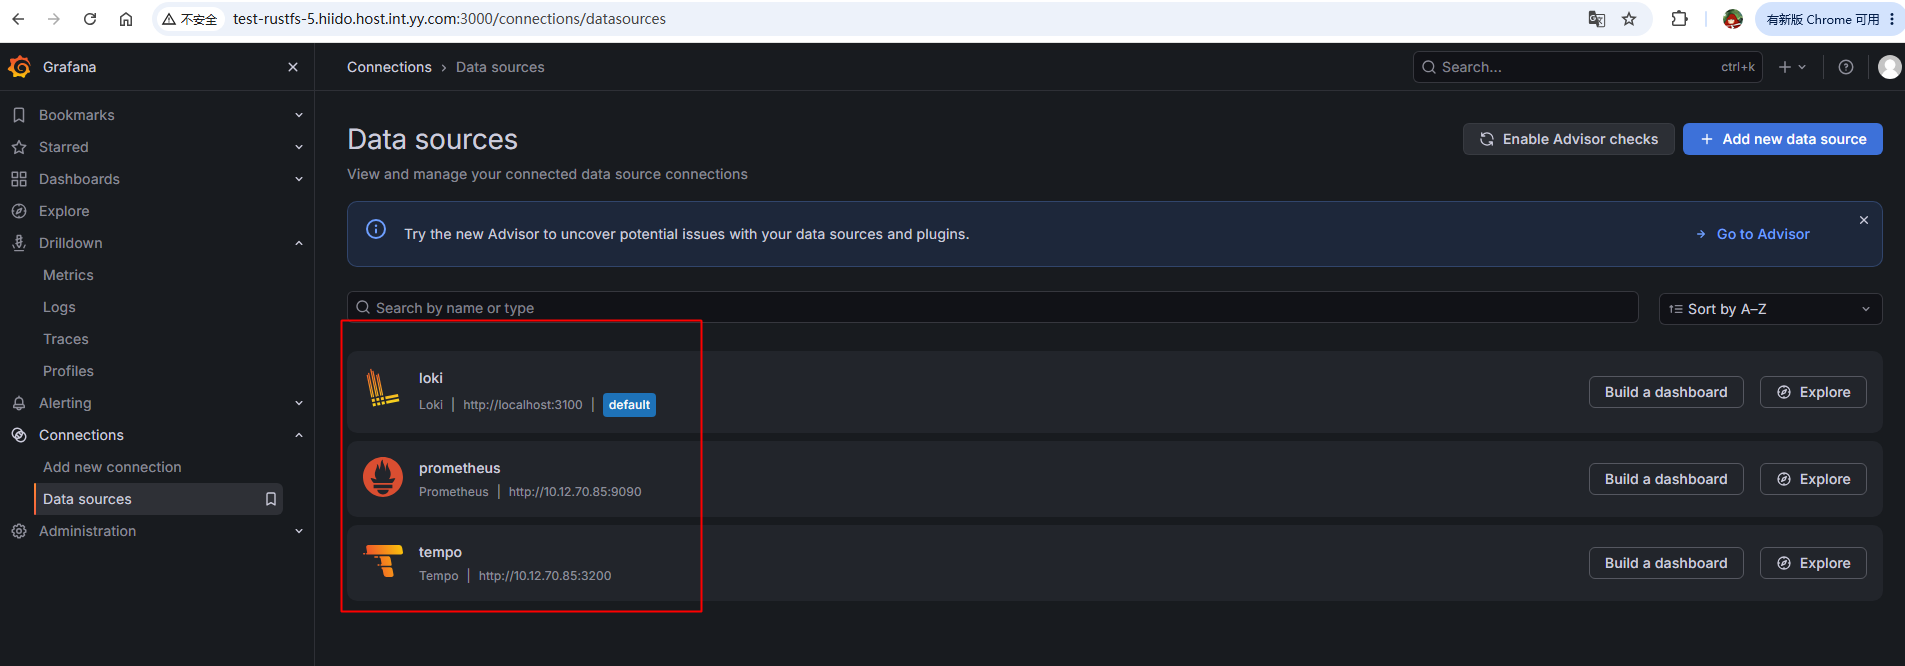
配置好数据源后,在dashboard中添加面板:
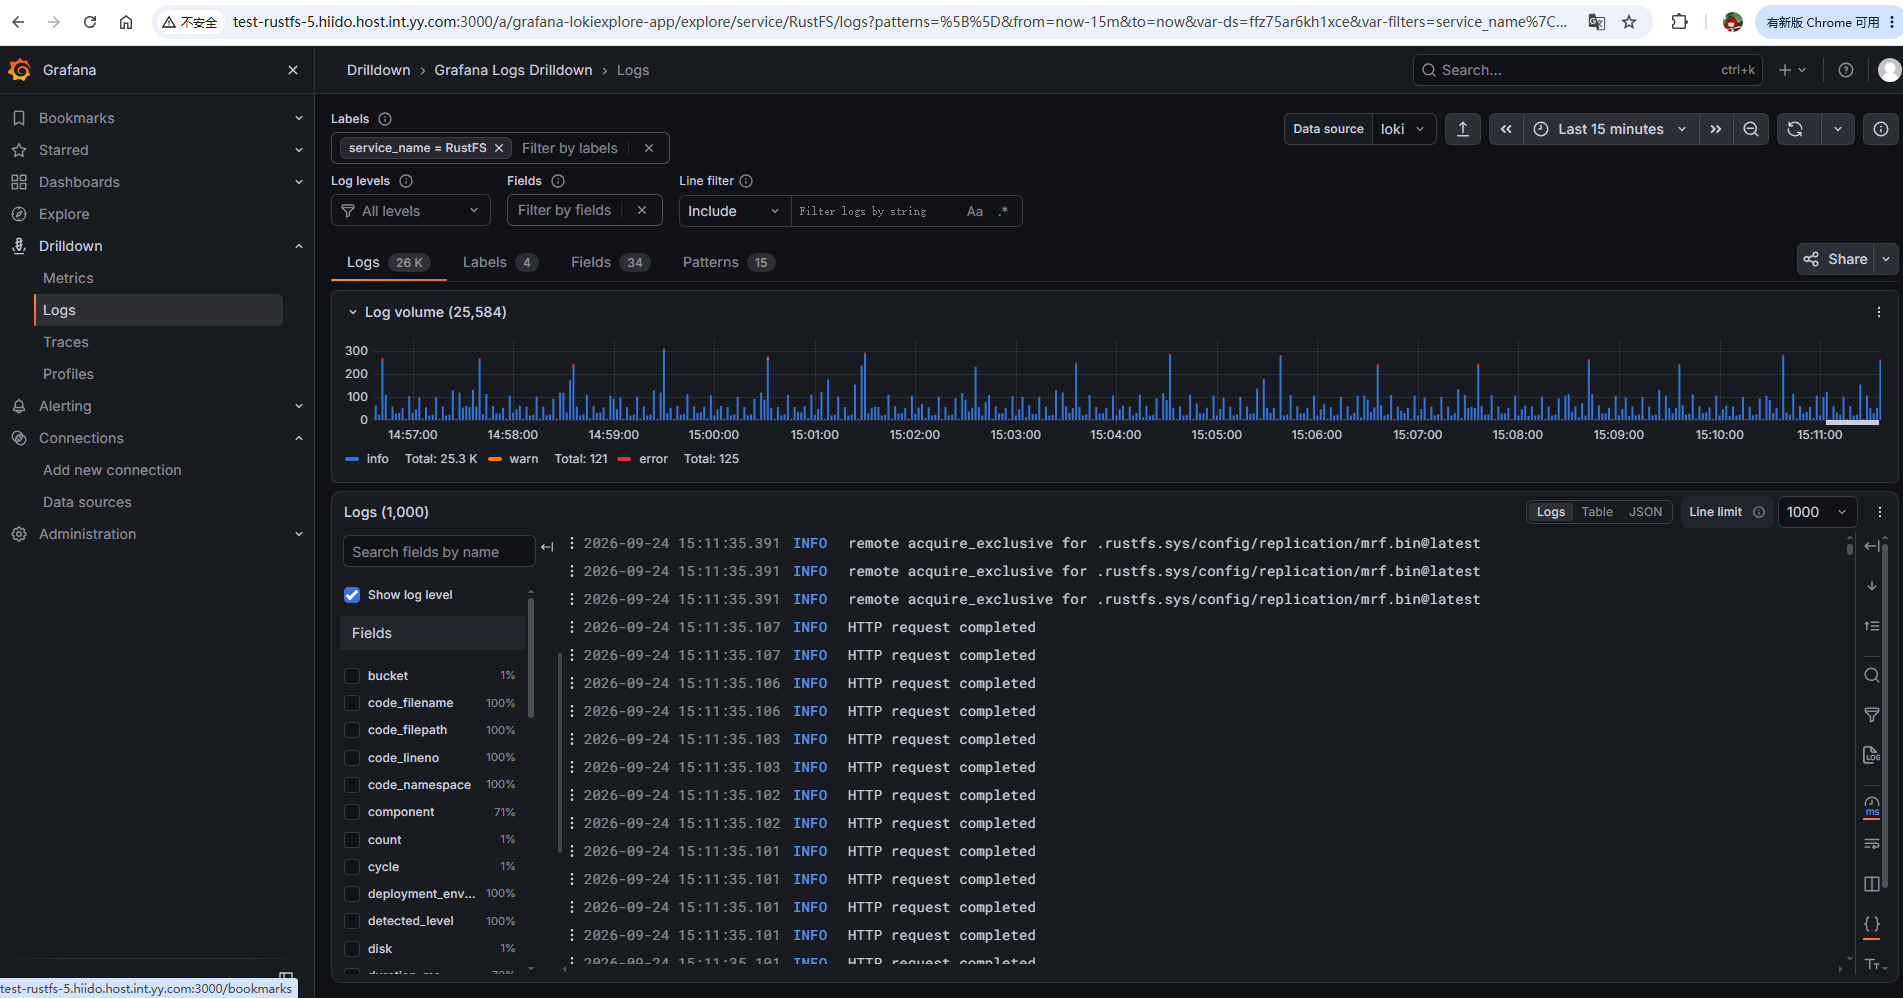
日志展示:
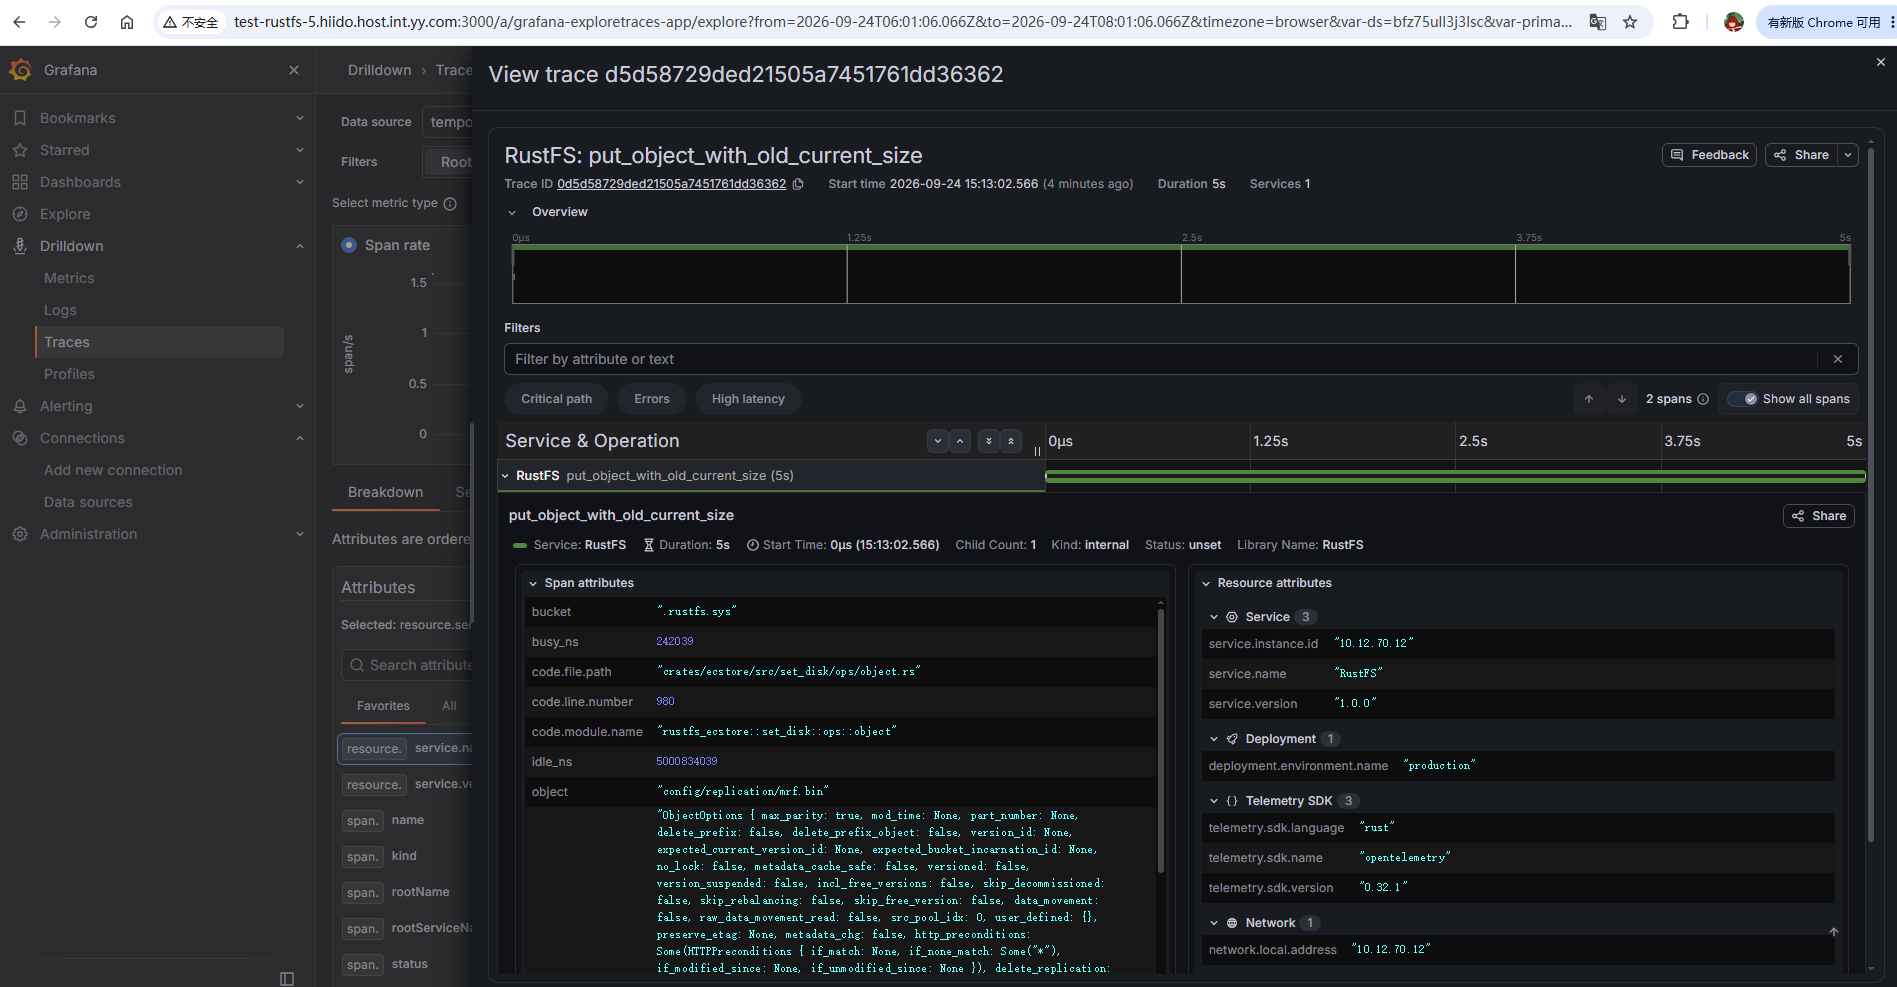
traces展示:
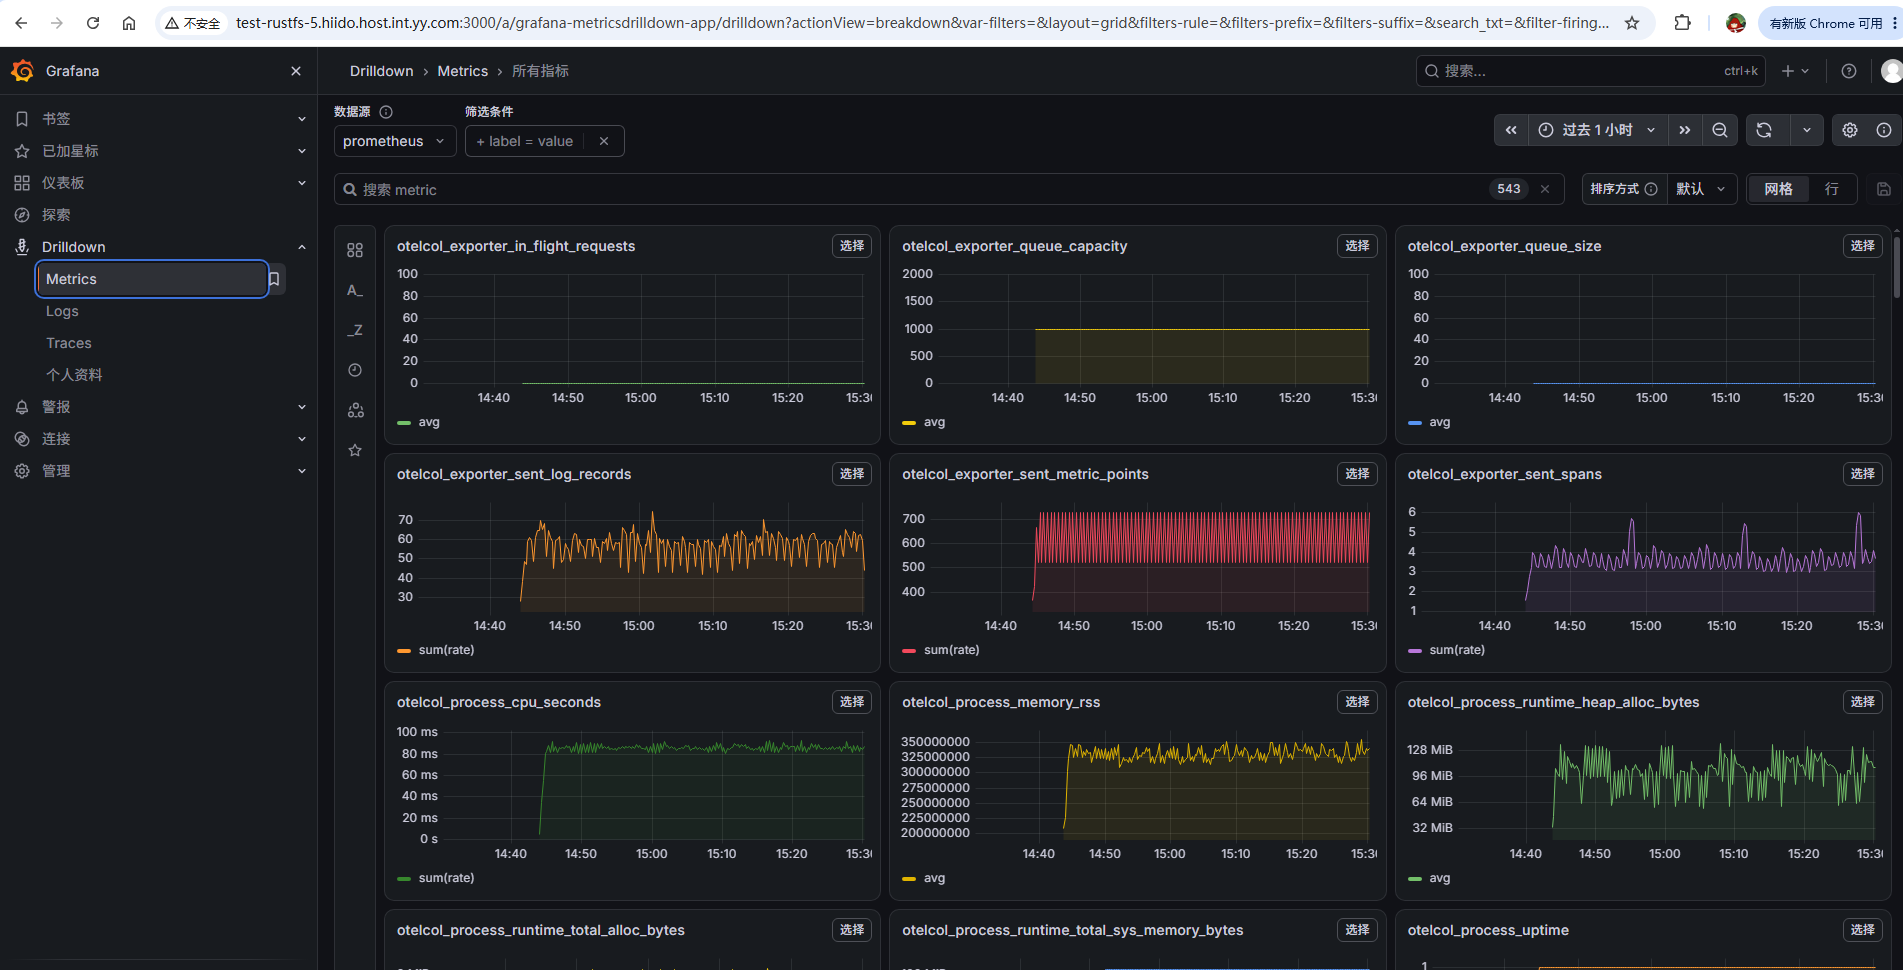
 metrics展示: